现代 CPU 的内存子系统,主要包括 on-CPU memory(SRAM/cache)和 off-CPU memory(DRAM)两部分。
DRAM 的层级为 CPU -> memory controller -> channel -> DIMM -> logical rank -> die -> bank group -> bank (-> MAT/Tile) -> memory cell at (row, column)。
device 和 die 的关系由封装决定,需要另外讨论。
device 和 logical rank 的关系具体由 logical rank 和 die 的关系,device 和 die 的关系,两者决定。
所以,这个栈里面的话题有:
- 1 memory cell 一路到 memory controller
- 1.1 memory cell 的电气原理
- 1.2 die 的构成
- memory cell 如何构成 MAT/Tile,
- MAT/Tile 如何构成 bank
- bank 如何构成 bank group
- 1.3 memory controller 与 die 的对接
- 地址映射
- 给定一个 PA
- memory controller 如何访问某一个 channel,某一个 logical rank 的所有 die
- 对这些 die,访问这些 die 的某一个 bank group,某一个 bank,某一个 row,某一个 column
- 数据访问命令:ACT / PRE / RD / WR
- 维护命令:REF / ZQ / MRS
- 时序
- 地址映射
- 2 device 和 die 之间的封装关系,单独讨论
- CPU
- 主板
- 内存插槽
- DIMM
- device / component / chip(黑色塑料颗粒)
- die(裸片)
从 CPU 到 logical rank、logical rank 到 die、die 到 memory cell,一路都是包含关系。
然后特殊关注一下 device 和 die 的关系、logical rank 和 device 的关系。
-
CPU 到 logical rank
- CPU、memory controller、channel 的关系
- 一个 CPU 和一个或多个 channel 相连
- 一个 memory controller 驱动一个或者所有 channel
- channel
- 每个 channel 有自己的 command address data 总线
- data 总线 64 bit
- channel 和 DIMM 的关系
- 一个 channel 有若干个 DIMM
- 一个 channel 的所有 DIMM 共享 channel 的总线
- DIMM
- data 总线 64 bit
- DIMM 和 logical rank 的关系
- 一个 DIMM 有若干 logical rank
- DIMM 通过 CS/CID 选择 logical rank
- logical rank
- data 64 bit
- CPU、memory controller、channel 的关系
-
logical rank 到 die
- 一个 logical rank 有若干 die
- 一个 logical rank 里的所有 die 的位宽和加起来,要满足 64 bit
-
die 到 memory cell
- die
- data x4, x8, x16
- die 和 bank group 的关系
- 一个 die 里有多个 bank group
- bank group
- bank group 和 bank 的关系
- 一个 bank group 里有多个 bank
- bank
- bank 和 MAT/Tile 和 memory cell 的关系
- 物理上 bank 是 MAT/Tile 的二维阵列
- 逻辑上 bank 是 memory cell 的二维矩阵
- MAT/Tile
- MAT/Tile 和 memory cell 的关系
- 一个 MAT/Tile 一般有 512x512 或者 1024x1024 个 memory cell
- memory cell
- die
-
特别注意 device 和 die 的关系(一个 device 可以包含多个 die)
以下仅为概念分类,和具体编码无关。
- Monolithic
- SDP
- Multi-load stack
- 常规 DDP
- QDP
- Single load stack
- SRx16 DDP
- 2H 3DS (TSV)
- 3H 3DS (TSV)
- 4H 3DS (TSV)
- 5H 3DS (TSV)
- 6H 3DS (TSV)
- 7H 3DS (TSV)
- 8H 3DS (TSV)
- Monolithic
-
特别注意 logical rank 和 device 的关系
logical rank 和 device 是正交关系。rank 是电气分组,device 是封装单位。
logical rank 和 device 的关系具体由 logical rank 和 die 的关系,device 和 die 的关系,两者决定。
一个 device 可以属于两个不同的 logical rank(DDP、2H 3DS),也可以只属于一个 logical rank(SDP SRx16 DDP)。
-
on-CPU memory
- 1 个 core 1 个 32KB L1 i-cache
- 1 个 core 1 个 32KB L1 d-cache
- 1 个 core 1 个 256KB L2 cache
- 1 个 CPU(6 个 core)1 个 12 MB L3 cache
- cache line size 64 B
- 1 个 CPU 1 个 memory controller
-
off-CPU memory
- 1 个 memory controller 支持 2 个 channel
- 1 个 channel 支持 2 个 DIMM(内存条)
- 1 个 DIMM 有若干个 logical rank(逻辑排)
-
L3 cache 向 memory controller 发送 PA
L3 cache 向 memory controller 发送 PA 0b11111111101010。
因为 cache line 大小 64 B,memory controller 需要把 0b11111111000000 开头的一整个 64 B line 从 DRAM 取过来,放进 L3 cache 中。
-
memory controller 发送命令和地址
地址部分:
memory controller 把地址拆成 channel、rank、bank group、bank、row、column、3 bit offset。
首先 memory controller 通过 CS 选择 rank。每个 rank 对应一根 CS 线。任一时刻,只能有一根 CS 线亮。
(memory controller 也可以通过 CID 选择 rank,具体不展开讨论。)
然后,把相同的 bank group、bank、row、column 喂给这个 rank 的所有 die。
注意,一个 rank 所有 die 的数据位宽加起来等于 64 bit。
命令部分:
memory controller 同时发送对应的命令。
-
信号通过 die 发送到 bank
bank 里的 row column 被执行命令。注意,一个 column 的大小实际上是 die 的位宽。
另外,CA(2:0) 在 bank 里用不到。
-
bank 把 8 个 column 的数据交给 die IO
对于 x4 位宽,就是 32 bit。
对于 x8 位宽,就是 64 bit。
对于 x16 位宽,就是 128 bit。
-
die 返回结果
die 分 8 拍,每次返回 1 个 column。8 个 column 的顺序由 CA(2:0) 决定。
对于 x4 位宽,就是 8 次 4 bit。
对于 x8 位宽,就是 8 次 8 bit。
对于 x16 位宽,就是 8 次 16 bit。
-
rank 的结果
rank 里面的每个 die,都会执行上面的操作。
每一拍出来的数据是 64 bit,对应上面的 3 bit offset。
8 拍一共出来 64 B,正好是一个 cache line。
需要注意的是,不管 CA(2:0) 怎么变,最后得到的 64B 都是一样的,只是每个 8B 出来的顺序不一样。
所以,0b11111111000000 和 0b11111111111000 得到的 64B 是一样的。也就是说,物理内存的最小寻址单位,实际上是一个 cache line。
对于一个 8Gb x8 的 die,16 个 bank,column 10 根线,row 16 根线。那么一个 bank 的逻辑结构是,2^16 个 row,2^10 个 column,一个 column 8 个 bit。
如果我们选用 512x512 的 MAT/Tile,那么我们需要 128 行 16 列 MAT/Tile。
-
PRECHARGE 命令
PRECHARGE 命令只需要 bank 地址,bank 内部已经记录 row。
- 降低该 bank high 的 wordline,16 个 MAT 会进行响应
- 关闭 senseamp,实际上需要关掉 16 个 MAT 上下两排的 senseamp
- Precharge unit 让 senseamp 电压回到 1/2 VDD,需要对 16 个 MAT 上下两排的 senseamp 进行操作
-
ACTIVATE 命令
ACTIVATE 需要 bank ID 和 row。
- 升高该 bank 该 row 的 wordline,16 个 MAT 会进行响应
- charge sharing
- 开启 senseamp,需要对 16 个 MAT 上下两排的 senseamp 进行操作
16 个 MAT 上下两排的 sense amp 最后会存放该 row 的数据 16x512bit。
这时 global sense amplifier 里的值没有意义,因为没有 CSL 来选择正确的 64 bit。
-
8n prefetch 和 Burst
进行读操作时。一个 bank 实际上一次会吐出 8n 的数据,即 8x4b、8x8b、8x16b,这些数据缓存在 die IO。die IO 分 8 次把 8n 的数据交给外界。
bank 与 die,一次交换 8n bit,一次 4 个周期,一共 1 次。这叫 8n prefetch。
die 与外界,一次交换 n bit,一次半个周期,一共 8 次。这叫 burst。
进行写操作时,外界分 8 次把 8n 的数据交给 die IO,然后 die IO 一次把 8n 的数据写到特定 bank 里。
-
Burst length, burst type, CA(2:0), burst order
我们最终只关注 burst order,即 8 个 n bit 的顺序。
burst order 由 burst length、burst type、CA(2:0) 决定。
-
burst type
由 Mode register 0 A3 read burst type 决定
- MR 0 A3 read burst type
- 0 sequential
- 1 interleave
- MR 0 A3 read burst type
-
burst length
由 Mode register 0 A1:A0 burst length 和 read/write 命令的 A12/BC_n 位决定
- MR 0 A1:A0 burst length
- 00 8 (Fixed) BL8MRS
- 10 BC4 (Fixed) BC4MRS
- 01 BC4 or 8 (on the fly) BC4OTF or BL8OTF
- A12/BC_n 0 BC4
- A12/BC_n 1 BL8
- 11 Reserved
Burst Read/ Starting burst type = burst type = Length Write Column Sequential Interleaved Address (decimal) A3=0 (decimal) A3=1 (A2,A1,A0) ------------------------------------------------------------------- 4 Chop READ 0 0 0 0,1,2,3,T,T,T,T 0,1,2,3,T,T,T,T 4 Chop READ 0 0 1 1,2,3,0,T,T,T,T 1,0,3,2,T,T,T,T 4 Chop READ 0 1 0 2,3,0,1,T,T,T,T 2,3,0,1,T,T,T,T 4 Chop READ 0 1 1 3,0,1,2,T,T,T,T 3,2,1,0,T,T,T,T 4 Chop READ 1 0 0 4,5,6,7,T,T,T,T 4,5,6,7,T,T,T,T 4 Chop READ 1 0 1 5,6,7,4,T,T,T,T 5,4,7,6,T,T,T,T 4 Chop READ 1 1 0 6,7,4,5,T,T,T,T 6,7,4,5,T,T,T,T 4 Chop READ 1 1 1 7,4,5,6,T,T,T,T 7,6,5,4,T,T,T,T 4 Chop WRITE 0 V V 0,1,2,3,X,X,X,X 0,1,2,3,X,X,X,X 4 Chop WRITE 1 V V 4,5,6,7,X,X,X,X 4,5,6,7,X,X,X,X 8 READ 0 0 0 0,1,2,3,4,5,6,7 0,1,2,3,4,5,6,7 8 READ 0 0 1 1,2,3,0,5,6,7,4 1,0,3,2,5,4,7,6 8 READ 0 1 0 2,3,0,1,6,7,4,5 2,3,0,1,6,7,4,5 8 READ 0 1 1 3,0,1,2,7,4,5,6 3,2,1,0,7,6,5,4 8 READ 1 0 0 4,5,6,7,0,1,2,3 4,5,6,7,0,1,2,3 8 READ 1 0 1 5,6,7,4,1,2,3,0 5,4,7,6,1,0,3,2 8 READ 1 1 0 6,7,4,5,2,3,0,1 6,7,4,5,2,3,0,1 8 READ 1 1 1 7,4,5,6,3,0,1,2 7,6,5,4,3,2,1,0 8 WRITE V V V 0,1,2,3,4,5,6,7 0,1,2,3,4,5,6,7 - MR 0 A1:A0 burst length
-
-
READ
READ 命令需要 bank ID 和 column。
其实很简单,CA(9:3) 对每一列 MAT(128 个 MAT),选择里面的 1 份 4 bit,128 根 column selection line 里面 1 根置 1。结果是 4 根 global bitlines 同时和 128 个 MAT 对应的 senseamp 相连。
此时一列 128 个 MAT 里,只有一个 MAT 的上下两排 senseamp 是开启的(ACTIVATE 的结果)是 0 或 1,其他 MAT 的 senseamp 都是关着的,电压在 1/2 VDD。所以只有这个开启的 senseamp,可以影响 global sense amplifiers。
真实电路里,通常会按 MAT-row 门控这个连接(只让活跃行的列选管子导通),而不是真把 127 个 MAT 的 idle SA 都挂上去指望它们不捣乱,挂太多 idle SA 会给 global bitline 加负载、甚至争抢。
相同的操作在 16 列 MAT 中同时进行,global sense amplifier 最后会得到 16x4 bit 数据。
最后得到 64 bit。这个 64 bit 会被一次放到 die IO 里(8n prefetch)。然后通过 burst 方式被从 die 里被发出去。burst order 上面有描述。
-
WRITE
WRITE 命令需要 bank ID 和 column。
外界分 8 次把 8n 的数据交给 die IO,然后 die IO 一次把 8n 的数据交给特定 bank 的 write driver。
write driver 负责把数据推上 GDL。
GDL 往上走到各个 MAT 列,经过 MAT 行选开关下到 LDL。这一级挡住了其他 127 个 MAT 行,所以数据只进被激活的那一行。
CA(9:3) 驱动绿色 CSL,打开选中位置的传输门,LDL 接上 sense amp。
关键动作:write driver 的驱动能力被设计得远强于 sense amp 的锁存器,硬把 latch 掀翻。比如原来锁的是 1(BL=VDD,BLB=0),要写 0,driver 就把 BL 强拉低、BLB 强拉高,latch 翻转。
wordline 全程没关过。latch 一翻,电容里的电荷就流进或流出,跟到新值。
-
READ/WRITE 还可以带 auto-precharge
ddr4 标准第 10 章 Speed Bin 和第 14 章 Electrical Characteristics & AC Timing 给出了和时序有关的信息。
-
Speed Grade
4 位数的单位是 M Transfer/s。这个数值是时钟频率乘 2(Double Data Rate)。
- 1600
- 1600J
- 1600K
- 1600L
- 1866
- 1866L
- 1866M
- 1866N
- 2133
- 2133N
- 2133P
- 2133R
- 2400
- 2400P
- 2400R
- 2400T
- 2400U
- 2666
- 2666T
- 2666U
- 2666V
- 2666W
- 2933
- 2933V
- 2933W
- 2933Y
- 2933AA
- 3200
- 3200W
- 3200AA
- 3200AC
- 1600
-
时钟周期 tCK
两章都给出了 tCK 平均值的范围。
-
Timing constraints
Timing constraints 决定了两条命令之间的最短时间间隔。
RAS 和 CAS 是以前异步 DRAM 的概念,被保留了下来。
另外注意单位。DRAM 芯片内有模拟电路也有数字电路。
电容的充放电、电压的爬升、模拟信号的放大,这些过程根本不知道「时钟频率」是什么。它们只服从物理学中的 RC 延迟公式。给一个特定工艺(比如 1z nm)的 DRAM 电容充满电,不管你外面跑的是 2133 的频率还是 3200 的频率,它需要的绝对物理时间是不变的(比如就是需要 14 纳秒)。
所以有些时序限制的单位是 ns。
DRAM 芯片边缘的接口电路(I/O Buffer)、命令解码器(Command Decoder)、并串转换器(MUX),这些是标准的数字逻辑电路。数字电路必须踩着外部传进来的时钟沿(Clock Edge)来干活。一个时钟周期(tCK)干一步,步调极其森严。
所以有些时序限制的单位是 CK。
有些时候,单位是 ns 的时序限制会用 CK 单位,这是经过换算了。
4 条基础命令之间的转移 command transition name full name ddr4 description PRECHARGE -> ACTIVATE tRP /ns Time of RAS Precharge PRE command period ACTIVATE -> PRECHARGE tRAS/ns Time of RAS ACT to PRE command [1] period ACTIVATE -> READ / WRITE tRCD/ns RAS to CAS Delay ACT to internal read [1] or write delay time READ -> PRECHARGE tRTP Read To Precharge Internal READ Command max(CK,ns) to PRECHARGE Command delay Last data -> PRECHARGE tWR /ns Write Recovery WRITE recovery time of WRITE enters die ACTIVATE -> ACTIVATE tRC Row Cycle Time 读写相关 READ -> First data CL /CK CAS Latency leaves die WRITE -> First data CWL/CK CAS Write Latency enters die 各类 penalty row miss with read tRP + tRCD + CL- 注意,tRAS 和 tRCD 是两个独立的时序限制。而且 t
一次 row miss = tRP + tRCD + CL,这是你 profiling 时"随机访问为什么慢"的答案。
-
第一组:三个核心延迟
- tRCD(RAS→CAS Delay):ACT → 能发 RD/WR 的最小间隔。等行缓冲把整行放大稳。
- CL / tCAS(CAS Latency):RD 登记 → 第一拍数据上 DQ。就是你刚钉死的那个 RL 的主体(RL=AL+CL+PL,平时=CL)。
- tRP(Row Precharge):PRE → 能再 ACT 的最小间隔。等位线回 VDD/2。
-
第二组:行的时长约束(开多久、多久一轮)
- tRAS(Row Active Time):ACT → PRE 的最小间隔。保证 restore 写回 cell 才准关行。
- tRC(Row Cycle):tRC = tRAS + tRP。同一 bank 一整个"开→关"周期,ACT 到下一个 ACT。
-
第三组:并行/节流(解释"为什么摊到 bank group",你自己推出来的那套)
- tCCD_S / tCCD_L(Column-to-Column Delay,短/长):两次列访问的最小间隔。不同 bank group 用 tCCD_S(≈4 CK,能背靠背无缝);同 bank group 用 tCCD_L(更长,出气泡)。
- tRRD_S / tRRD_L(Row-to-Row Delay):两条 ACT 的最小间隔,不同/同 bank group。
- tFAW(Four Activate Window):任意窗口内最多 4 个 ACT(功耗约束)。
-
第四组:写相关(读的镜像 + 写独有)
- CWL(CAS Write Latency):WR 登记 → 第一拍写数据上 DQ(写的 CL)。
- tWR(Write Recovery):写完 → 能 PRE。等新值充分写回 cell 电容。
- tWTR_S/L(Write-to-Read):写转读的总线转向间隔。
- tRTP(Read-to-Precharge):读 → 能 PRE 的间隔。
-
第五组:刷新(偷带宽的那部分)
- tREFI(Refresh Interval):平均多久发一次 REF ≈7.8µs。
- tRFC(Refresh Cycle):一次 REF 占芯片多久(比普通命令长很多)。
- 保持时间约 64ms:一行必须在这内被刷一遍。
-
第六组:数据选通(你刚吃透的那张图上的)
- tDQSCK:读时 DQS 相对 CK 的偏移(那张多情况叠加图量的就是它)。
- tDQSQ:DQS 边沿到 DQ 有效的偏移(有效窗口前沿)。
- tQH:DQ 保持有效的时间(有效窗口后沿);可采窗口 = tQH − tDQSQ。
- tRPRE / tRPST:读突发的前导/后导(RL 终点前那段预热 + 尾巴)。
-
加速手段
-
multi-port
不推荐,连线数量增加,memory cell 面积也会变大,走线拥挤导致寄生电容剧增、读写速度变慢,功耗发热原地起飞。
一般只有寄存器堆才用 multi-port。
cache、DRAM 都是 single-port。
-
multi-bank
cache、DRAM 都使用 multi-bank 的方法加速访存。
-
- Committee
- JC-42 Sold State Memories Committee
- JC-42.1 Graphics RAMs (GDDRx)
- JC-42.2 High Bandwidth Memory (HBM)
- JC-42.3 Dynamic RAMs (DDRx)
- JC-42.4 Non-Volatile Memory Devices
- JC-42.5 Alternative Memory
- JC-42.6 Low Power Memories
- JC-42.9 Automotive Steering
- JC-45 DRAM Modules
- JC-42 Sold State Memories Committee
- Documentation
- JESD21-C: JEDEC Configurations for Solid State Memories
- MODULE4.20.26: 288-Pin, 1.2 V (VDD), PC4-1600/PC4-1866/PC4-2133/PC4-2400/PC4-2666/PC4-3200 DDR4 SDRAM Unbuffered DIMM Design Specification, Aug 2019
- SPD4.1.2.L-5: SPD Annex L: Serial Presence Detect (SPD) for DDR4 SDRAM Modules, Release 5, Aug 2019
- https://www.jedec.org/category/technology-focus-area/memory-configurations-jesd21-c
- https://www.jedec.org/sites/default/files/21C_TOCR29.pdf
- 包含物理尺寸图纸
- 引脚定义图
- 芯片封装标准
- Double data rate synchronous dynamic RAM
- JESD79F: DOUBLE DATA RATE (DDR) SDRAM STANDARD, Feb 2008
- JESD79-2F: DDR2 SDRAM STANDARD, Nov 2009
- JESD79-3F: DDR3 SDRAM STANDARD, Jul 2012
- JESD79-4D: DDR4 SDRAM STANDARD, Jul 2021
- JESD79-5D: DDR5 SDRAM, Nov 2025
- Low power double data rate synchronous dynamic RAM
- JESD209B: LOW POWER DOUBLE DATA RATE (LPDDR) SDRAM STANDARD, Feb 2010
- JESD209-2F: LOW POWER DOUBLE DATA RATE 2 (LPDDR2), Jun 2013
- JESD209-3C: LOW POWER DOUBLE DATA RATE 3 SDRAM (LPDDR3), Aug 2015
- JESD209-4E: Low Power Double Data Rate 4 (LPDDR4), Jun 2024
- JESD209-5C: LOW POWER DOUBLE DATA RATE (LPDDR) 5/5X, Jul 2023
- JESD209-6: LPDDR6 Standard, Jul 2025
- Graphics double data rate synchronous graphics RAM
- SDRAM3.11.5.6: GDDR2 Specific SGRAM Functions, May 2005
- SDRAM3.11.5.7: GDDR3 Specific SGRAM Functions, May 2005
- SDRAM3.11.5.8 R16.01: Graphics Double Data (GDDR4) SGRAM Standard, Mar 2023
- JESD212C.01: GRAPHICS DOUBLE DATA RATE (GDDR5) SGRAM STANDARD, Jan 2023
- JESD232A.01: GRAPHICS DOUBLE DATA RATE (GDDR5X) SGRAM STANDARD, Mar 2023
- JESD250D: Graphics Double Data Rate (GDDR6) SGRAM Standard, May 2023
- GDDR6X 没有 JEDEC 标准,是 Nvidia 和 Micron 自己搞的
- JESD239E: Graphics Double Data Rate 7 SGRAM Standard (GDDR7), May 2026
- High bandwidth memory dynamic RAM
- JESD235D: HIGH BANDWIDTH MEMORY (HBM) DRAM, Mar 2021
- JESD238B.01: High Bandwidth Memory (HBM3) DRAM, Apr 2025
- JESD270-4A, High Bandwidth Memory (HBM4) DRAM, Dec 2025
- JESD21-C: JEDEC Configurations for Solid State Memories
https://product.skhynix.com/products/dram/ddr/ddr4sd.go
H5AN 4G 6 N B J R-VK C 4Gb     x16     2666Mbps        FCBGA   MP
H5AN 4G 6 N B J R-VK I 4Gb     x16     2666Mbps        FCBGA   MP
H5AN 4G 8 N B J R-VK C 4Gb     x8      2666Mbps        FCBGA   MP
H5AN 4G 8 N B J R-VK I 4Gb     x8      2666Mbps        FCBGA   MP
H5AN 8G 6 N C J R-VK C 8Gb     x16     2666Mbps        FCBGA   MP
H5AN 8G 6 N C J R-WM C 8Gb     x16     2933Mbps        FCBGA   MP
H5AN 8G 6 N C J R-WM I 8Gb     x16     2933Mbps        FCBGA   MP
H5AN 8G 6 N C J R-XN C 8Gb     x16     3200Mbps        FCBGA   MP
H5AN 8G 6 N C J R-XN I 8Gb     x16     3200Mbps        FCBGA   MP
H5AN 8G 6 N D J R-VK C 8Gb     x16     2666Mbps        FCBGA   MP
H5AN 8G 6 N D J R-WM C 8Gb     x16     2933Mbps        FCBGA   MP
H5AN 8G 6 N D J R-XN C 8Gb     x16     3200Mbps        FCBGA   MP
H5AN 8G 8 N C J R-VK C 8Gb     x8      2666Mbps        FCBGA   MP
H5AN 8G 8 N C J R-VK I 8Gb     x8      2666Mbps        FCBGA   MP
H5AN 8G 8 N C J R-WM C 8Gb     x8      2933Mbps        FCBGA   MP
H5AN 8G 8 N C J R-WM I 8Gb     x8      2933Mbps        FCBGA   MP
H5AN 8G 8 N C J R-XN C 8Gb     x8      3200Mbps        FCBGA   MP
H5AN 8G 8 N D J R-VK C 8Gb     x8      2666Mbps        FCBGA   MP
H5AN 8G 8 N D J R-WM C 8Gb     x8      2933Mbps        FCBGA   MP
H5AN 8G 8 N D J R-XN C 8Gb     x8      3200Mbps        FCBGA   MP
H5AN AG 6 N C J R-VK C 16Gb    x16     2666Mbps        FCBGA   MP
H5AN AG 6 N C J R-WM C 16Gb    x16     2933Mbps        FCBGA   MP
H5AN AG 6 N C J R-XN C 16Gb    x16     3200Mbps        FCBGA   MP
H5AN AG 6 N C M R-VK C 16Gb    x16     2666Mbps        FBGA    MP
H5AN AG 6 N C M R-VK I 16Gb    x16     2666Mbps        FBGA    MP
H5AN AG 6 N C M R-WM C 16Gb    x16     2933Mbps        FBGA    MP
H5AN AG 6 N C M R-XN C 16Gb    x16     3200Mbps        FBGA    MP
H5AN AG 6 N C M R-XN I 16Gb    x16     3200Mbps        FBGA    MP
H5AN AG 6 N D M R-VK C 16Gb    x16     2666Mbps        FBGA    MP
H5AN AG 6 N D M R-WM C 16Gb    x16     2933Mbps        FBGA    MP
H5AN AG 6 N D M R-XN C 16Gb    x16     3200Mbps        FBGA    MP
H5AN AG 8 N C J R-XN C 16Gb    x8      3200Mbps        FCBGA   MP
H5AN AG 8 N C M R-VK C 16Gb    x8      2666Mbps        FBGA    MP
H5AN AG 8 N C M R-VK I 16Gb    x8      2666Mbps        FBGA    MP
H5AN AG 8 N C M R-WM C 16Gb    x8      2933Mbps        FBGA    MP
H5AN AG 8 N C M R-XN C 16Gb    x8      3200Mbps        FBGA    MP
H5AN AG 8 N C M R-XN I 16Gb    x8      3200Mbps        FBGA    MP
H5AN AG 8 N D M R-VK C 16Gb    x8      2666Mbps        FBGA    MP
H5AN AG 8 N D M R-WM C 16Gb    x8      2933Mbps        FBGA    MP
H5AN AG 8 N D M R-XN C 16Gb    x8      3200Mbps        FBGA    MP
H5AN BG 6 N A M R-VK C 32Gb    x16     2666Mbps        FBGA    MP
H5AN BG 6 N A M R-WM C 32Gb    x16     2933Mbps        FBGA    MP
H5AN BG 6 N A M R-XN C 32Gb    x16     3200Mbps        FBGA    MP
H5AN BG 8 N A B R-VK C 32Gb    x8      2666Mbps        FBGA    MP
H5AN BG 8 N A B R-WM C 32Gb    x8      2933Mbps        FBGA    MP
H5AN BG 8 N A B R-XN C 32Gb    x8      3200Mbps        FBGA    MP
-
DDR4 component 命名规则,具体文档在 https://product.skhynix.com/support/downloads/techs.go
- SK Hynix MEMORY
- H
- PRODUCT FAMILY
- 5: DRAM
- PRODUCT MODE
- A: DDR4 SDRAM
- POWER SUPPLY
- N: VDD & VDDQ = 1.2V
- DENSITY & REFRESH
- 1G: 1Gb
- 2G: 2Gb
- 4G: 4Gb
- 8G: 8Gb
- AG: 16Gb
- BG: 32Gb
- ORGANIZATION
- 4: x4
- 8: x8
- 6: x16
- DIE TYPE
- N: Non-TSV
- T: TSV
- DIE GENERATION
- M: 1st
- A: 2nd
- B: 3rd
- C: 4th
- D: 5th
- E: 6th
- F: 7th
- G: 8th
- PACKAGE TYPE
- F: FBGA SDP
- J: Flipchip SDP
- M: FBGA DDP (Dual-Die Package)
- P: Flipchip Planar DDP
- 2: TSV 2 high stack
- 4: TSV 4 high stack
- B: ?
- PACKAGE MATERIAL
- R: Lead Free & Halogen Free (ROHS compliant)
- SPEED(tCL-tRCD-tRP)(注意 tRCD 和 tRP 的单位是 ns,下面的数值是换算出来的周期数)
- TF: DDR4-2133 15-15-15
- UH: DDR4-2400 17-17-17
- UL: DDR4-2400 20-18-18
- VK: DDR4-2666 19-19-19
- VN: DDR4-2666 22-19-19
- WM: DDR4-2933 21-21-21
- XN: DDR4-3200 22-22-22
- OPERATING TEMPERATURE & POWER CONSUMPTION
- C: Commercial Temp(0°C ~ 85°C) & Normal Power
- R: Commercial Temp(0°C ~ 85°C) & Reduced IDD6
- I: ?
- SK Hynix MEMORY
-
封装类型详解
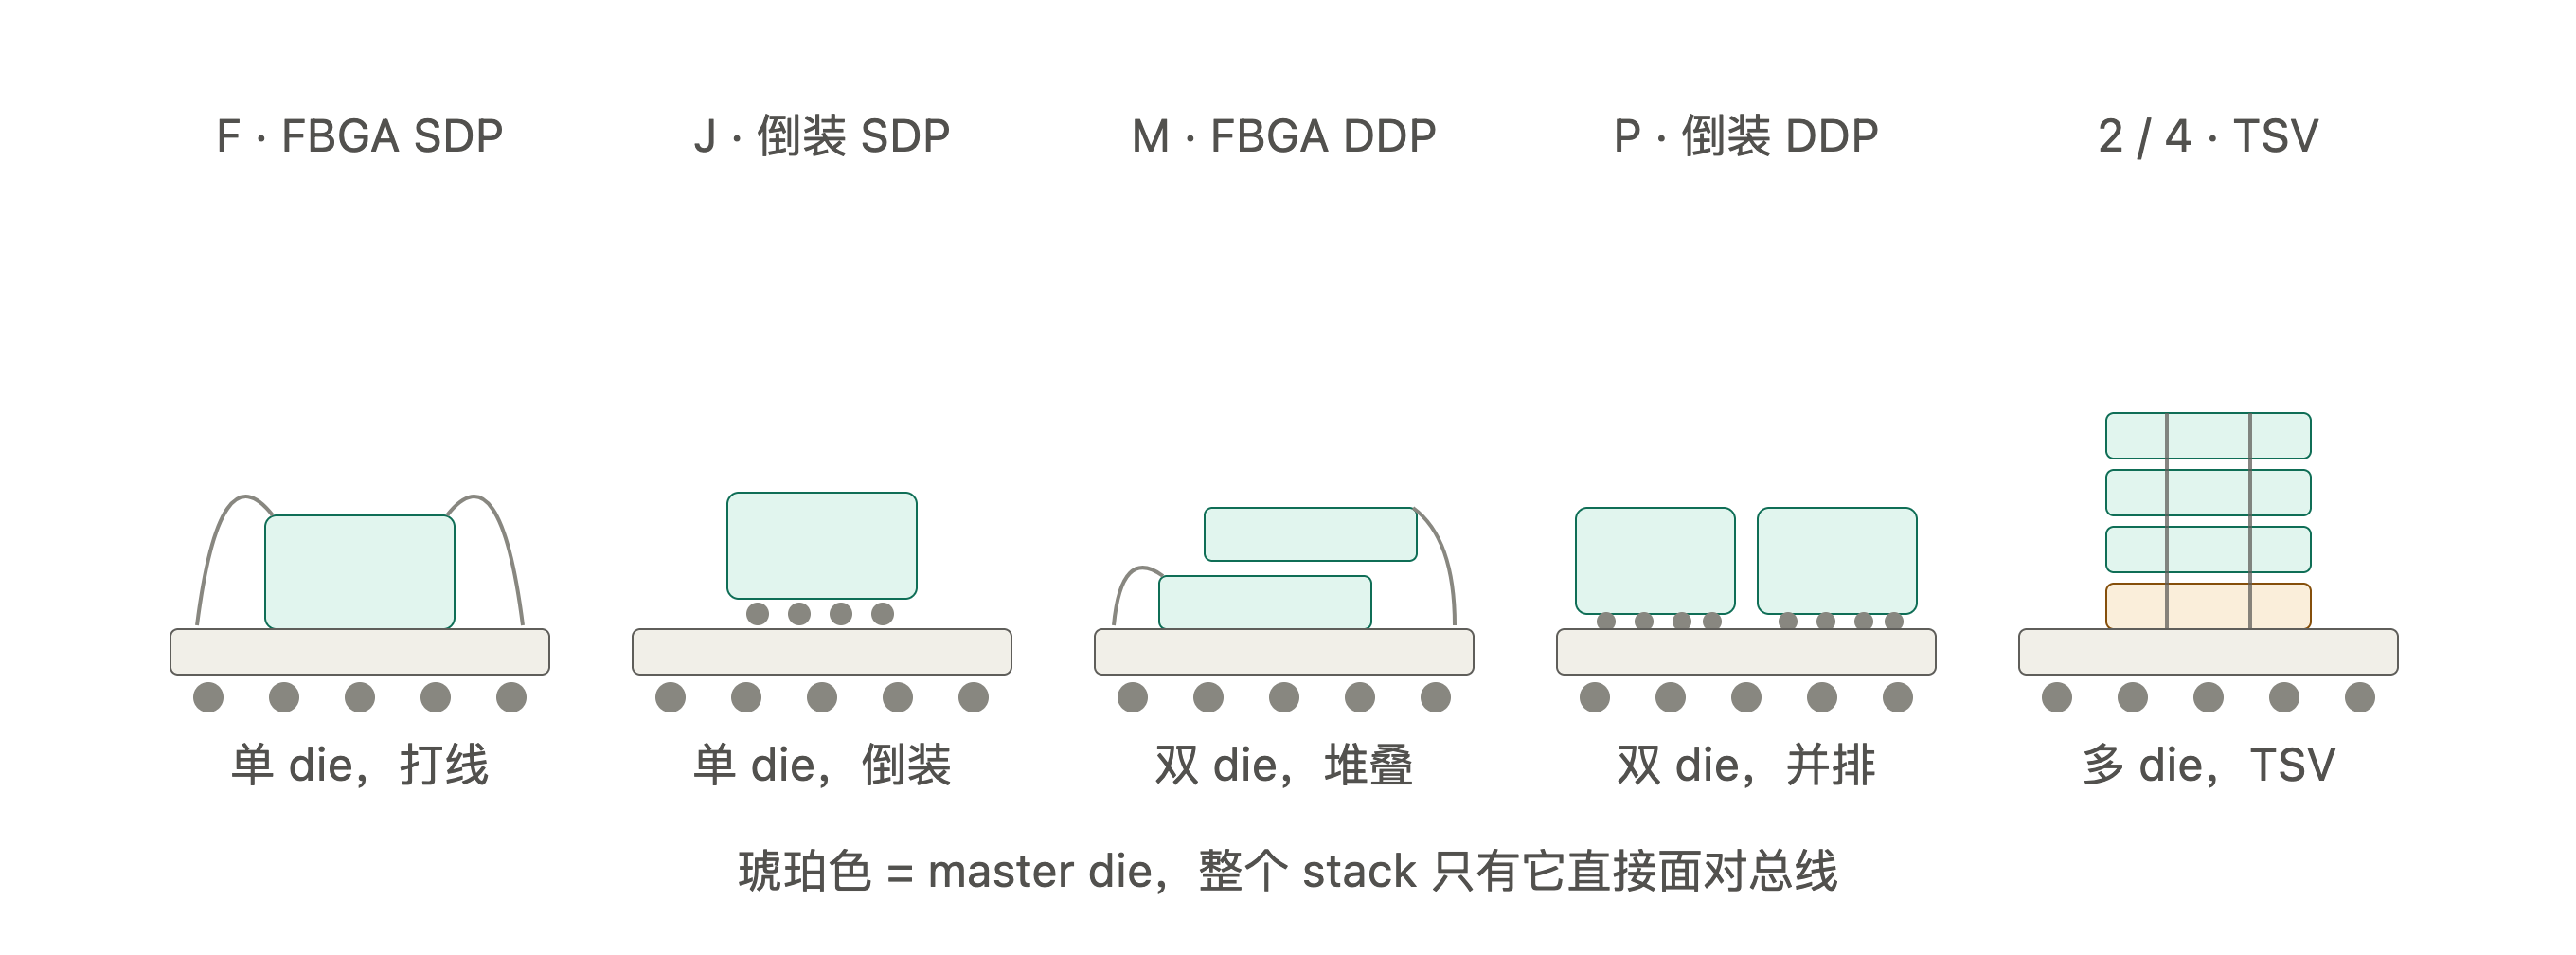
-
FBGA SDP
FBGA 是 fine-pitch BGA,指封装外形(底部细间距锡球阵列)。这里隐含的是打线(wire bond)互连:die 正面朝上贴在基板上,用金/铜线把 pad 连到基板。
SDP = single die package,一颗 die。最便宜、最传统的做法。
— Flipchip SDP
同样一颗 die,但 die 翻过来正面朝下,用凸块(bump)直接落在基板上,没有 bond wire。好处是寄生电感和电阻小得多、电源/地路径短,SI 和 PI 都好;die 背面朝上散热也更方便。所以高速档位(DDR4-3200 以上、DDR5、LPDDR)基本都走 flipchip。
-
FBGA DDP
DDP = dual die package,两颗 die 叠在一起,阶梯式错开好露出下面那颗的 bond pad,再分别打线。容量翻倍,但 DQ/CA 总线上挂的电容负载也接近翻倍,所以同容量下能跑的频率通常比 SDP 低一档。两颗 die 一般各有自己的 CS,对控制器来说是两个 rank(或者组成一个更宽的 rank)。
— Flipchip Planar DDP
两颗 die,但 planar = 平铺并排放在基板上,不是叠起来的。因为 flipchip 的 bump 面朝下,想垂直叠必须走 TSV,否则上面那颗没法连出来,所以只能并排。代价是封装面积变大,好处是保留了 flipchip 的电气和散热优势。负载上仍然是两颗 die 的量。
— TSV 2-high / 4-high stack
这就是 3DS(3D stacked)。die 被减薄,TSV 把上下层用 microbump 连起来。关键点在于:只有最底下的 master die 面向外部总线,上面的 slave die 全部挂在 master 后面通过 TSV 通信。所以不管堆 2 层还是 8 层,DQ/CA 上只有一个电气负载——这是它跟 DDP 的本质区别,也是 128GB / 256GB RDIMM 能做出来的原因。逻辑上用 CID(C0/C1/C2)选层,看起来像多个 rank。
代价是 TSV 工艺贵、良率低、需要控制器支持 3DS 模式,而且热密度高、tRFC 更长(要刷的 die 更多)。
-
TODO 把PPT看掉、把GDDR6看一下、把 cache 高级设计看一下、完成kernel具体执行的例子、完善roofline model。